等面授開課
- 要配合班表,趕不上就等下一期
- 上課節奏由講師帶,錯過難重看
- 重點靠當堂筆記,事後難定位
- 下課後才知道有沒有真正學會

IT專才培訓 - 技術與學術兼備
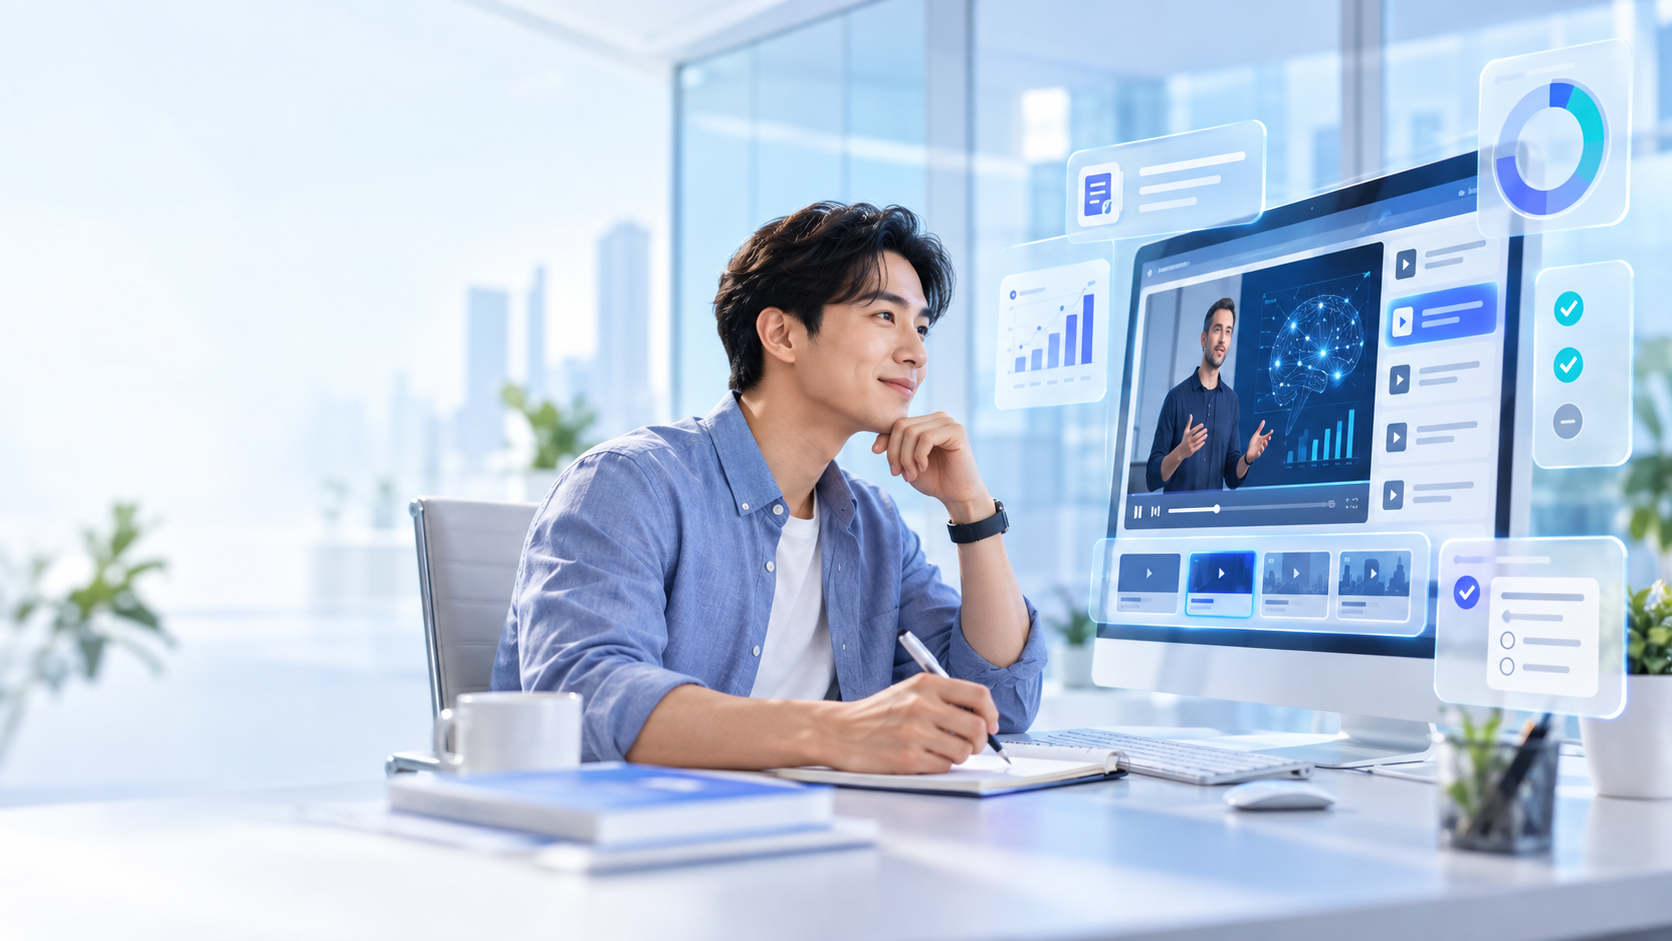
內容就是面授班的錄影。報讀後進入學習系統即可播放,不必遷就下一期班表。
可重看難點、跳過已懂部分,也可標示已完成。播放器支援上一課/下一課與進度列。
AI 根據完整課堂逐字稿整理時間章節與摘要;每課附測驗,對應學習系統裡的 Take Quiz。
利用 Python 和 Machine Learning 從歷史資料建立預測模型,並把預測結果帶回 Excel 支援決策。
本課為機器學習的入門課程,首先介紹機器學習與一般資料分析的差異,著重於如何透過演算法從資料中學習規則並建立預測模型,同時示範在本地環境安裝 Python、Jupyter Notebook 以及 Scikit-Learn、Pandas、Matplotlib 等關鍵套件。隨後課程深入探討資料預處理(Preprocessing)流程,涵蓋使用 Pandas 與 Scikit-Learn 的 SimpleImputer 處理缺失值(填補平均數或眾數),並利用常態分佈標準差及四分位距(IQR)方法透過箱形圖精準識別與過濾離群值。最後講解類別特徵編碼技術,包括 LabelEncoder、OrdinalEncoder 及 One-Hot Encoder,並透過 MinMaxScaler 進行特徵縮放以平衡數值範圍,為後續模型訓練奠定穩固基礎。
展開以垃圾郵件過濾為例說明演算法如何從數據中挖掘規則,並闡述資料預處理、選擇演算法、模型訓練及評估等四大核心階段。
展開在命令提示字元中啟動 Jupyter Notebook,並匯入 Pandas 與 Matplotlib 套件,建立學生成績 Excel 測試資料集。
展開介紹資料表中缺失值(NaN)的概念,使用 isnull() 檢查缺失數據,並探討刪除列、填補平均數或中位數等不同處理策略。
展開運用 Scikit-Learn 的 SimpleImputer 工具,以平均數或眾數標準化流程對數值與類別缺失欄位進行擬合(fit)與轉換(transform)。
展開說明離群值(Outlier)對模型訓練精確度的負面影響,並介紹常態分佈(Bell Curve)鐘形曲線與標準差的統計原理。
展開示範如何利用 plt.hist 繪製成績分佈直方圖,並使用 plt.subplot 在同一圖表中呈現多個欄位分佈情況。
展開利用箱形圖展示數據的中位數、第一四分位數(Q1)、第三四分位數(Q3),並透過圖形直觀識別極端偏離的數據點。
展開計算欄位平均數加減三個標準差作為上下邊界,嘗試藉此定義並過濾超出正常範圍的極端離群值。
展開計算第一四分位數(Q1)與第三四分位數(Q3)的四分位距(IQR),設定上下限閥值精確過濾出如異常低分的離群樣本。
展開說明模型無法直接接收文字資料的原因,並使用 LabelEncoder 與 OrdinalEncoder 將文字特徵轉換為整數數值標籤。
展開實作 One-Hot Encoder 將非順序類別特徵轉換為二元獨立欄位,並將生成的特徵與原始 DataFrame 進行合併。
展開使用 MinMaxScaler 將數值特徵縮放至 0 到 1 區間以避免尺度過大主導訓練,並預告下一節將使用公開資料集訓練決策樹模型。
展開每課 Quiz 及格分數為 60 分。在學習系統完成測驗並達標後,可向 UNiSOFT 申請由學校發出的課程證書。完整測驗、成績與重做次數於系統內進行(demo / demo)。
本課重點講授機器學習中的監督式學習(Supervised Learning)與決策樹分類(Decision Tree Classifier)。課程首先介紹如何使用 scikit-learn 載入內建的鳶尾花(Iris)數據集,並利用 Excel 深入拆解特徵(Features)與目標標籤(Target)的資料結構。接著詳細示範利用 train_test_split 將數據按 8:2 比例分割為訓練集與測試集,並建立、訓練決策樹模型,再透過 matplotlib 繪製決策樹架構。隨後導師深入講解決策樹以吉尼不純度(Gini Impurity)為基準尋找最佳分割點的底層數學原理。在模型評估方面,課程剖析混淆矩陣(Confusion Matrix)的結構,闡明 True Positive、True Negative、False Positive 及 False Negative 的意涵,並計算準確率、精確率及召回率。最後學員將整套流程遷移至葡萄酒(Wine)數據集進行實戰訓練與評估。
展開回顧機器學習基本概念,並在命令提示字元中啟動 Jupyter Notebook 建立第二課檔案。
展開介紹 scikit-learn 內建的 Iris 數據集及其四個特徵與三個花種分類標籤。
展開檢視 iris.data、iris.target 與特徵名稱,並複製至 Excel 示範資料分割與結構對應。
展開說明機器學習第一步需將特徵欄位(X)與目標欄位(y)進行垂直切分。
展開使用 train_test_split 將數據隨機按八成訓練、兩成測試的比例切分為四個子集。
展開探討監督式學習的定義,並區分數值預測(回歸)與標籤預測(分類)的差異。
展開建立決策樹分類器實例,設定 random_state,並呼叫 fit 方法對訓練集進行訓練。
展開利用 plot_tree 繪製決策樹分支圖,並說明如何讀取判斷規則與節點條件。
展開利用 model.predict 對測試集特徵進行預測,並將預測結果與真實標籤比對。
展開從 sklearn.metrics 引入評估指標,並說明多分類問題需設定 average='weighted'。
展開透過 ConfusionMatrixDisplay 繪製圖形化混淆矩陣,清楚檢視分類命中與失誤。
展開以食物安全性範例手動演練排序、平均中位數分割,並詳細計算吉尼不純度(Gini Impurity)。
展開以驗孕情境為例,詳細拆解 TP、TN、FP、FN 的定義及其在評估錯誤時的取捨。
展開將完整決策樹訓練與評估程式碼遷移至 Wine 數據集進行訓練、繪圖與成效檢驗。
展開總結本日模型建立要點,預告下一課將探討回歸分析、Streamlit 部署與大型語言模型概念。
展開每課 Quiz 及格分數為 60 分。在學習系統完成測驗並達標後,可向 UNiSOFT 申請由學校發出的課程證書。完整測驗、成績與重做次數於系統內進行(demo / demo)。
本課重點介紹 Python 數據分析與機器學習的核心技術。課程首先深入探討 NumPy 的多維陣列(N-dimensional Array)操作,涵蓋多層陣列索引、維度屬性(ndim 與 shape)、形狀重塑(reshape)、序列生成(linspace 與 arange),以及利用 random 模組生成隨機數與依機率分佈抽樣(choice),並示範了陣列的廣播機制(broadcasting)與統計運算。接著,課堂介紹資料視覺化庫 Seaborn,說明如何載入內建資料集、設定圖表風格、調色板(color palette)以及運用 relplot 搭配 hue 和 col 參數呈現多維度資訊。最後,課程進行線性迴歸(Linear Regression)的實戰專案,逐步示範載入資料、檢查無效負數與缺失值、利用 SimpleImputer 填補缺失值、LabelEncoder 編碼、StandardScaler 特徵縮放,進而計算相關性矩陣(correlation matrix),分割訓練與測試集,建立線性迴歸模型並利用均方誤差(MSE)與 R2 分數評估模型成效。
展開介紹 NumPy 陣列基礎,並示範二維與三維陣列的多層索引與切片操作。
展開示範如何檢視陣列 shape 屬性,並使用 reshape 改變陣列形狀。
展開探討 linspace 與 arange 生成等距數列,並使用 random.randint 與 choice 抽樣。
展開解說 max、mean、median 等統計功能,以及廣播機制在陣列算術運算中的應用。
展開介紹 Seaborn 庫的安裝與匯入,並示範載入 Iris 與 Tips 等內建資料集。
展開說明如何使用 set_style 與 despine 調整圖表邊框,並透過字典修改背景顏色。
展開介紹如何查看及設定 Seaborn 的色板,並利用 palplot 檢視色彩分佈。
展開示範使用 relplot 繪製散佈圖,並透過 hue 與 col 參數展示額外維度。
展開讀取 reviews.csv 檔案,利用 head、shape 與 isnull 檢查資料集結構與缺失值。
展開過濾價格與更新天數為負數的無效資料,並使用 SimpleImputer 以平均值填補缺漏。
展開使用 LabelEncoder 將文字類別轉換為數值,再以 StandardScaler 進行資料標準化。
展開計算資料特徵之間的相關係數(corr),分析各變數對目標評級的影響權重。
展開利用 train_test_split 將特徵與標籤拆分為訓練集與測試集(80/20 比例)。
展開訓練 LinearRegression 模型,印出係數與截距,並以均方誤差及 R2 分數評估成效。
展開每課 Quiz 及格分數為 60 分。在學習系統完成測驗並達標後,可向 UNiSOFT 申請由學校發出的課程證書。完整測驗、成績與重做次數於系統內進行(demo / demo)。
本堂課主要介紹如何運用 Python 進行網絡數據交互,以及利用 Streamlit 構建與部署機器學習應用的完整流程。課程前半段首先講解 REST 架構與 HTTP 請求動詞(GET、POST、PUT、DELETE),並透過 requests 套件實作 JSONPlaceholder 測試 API,示範將 JSON 數據轉換為 Pandas DataFrame;接著實測香港金融管理局(HKMA)及香港政府 OpenAPI 獲取學校地理位置等真實數據。後半段則介紹開源前端框架 Streamlit,說明文字顯示、表單輸入、圖表繪製等基礎元件。最後以鳶尾花(Iris)數據集為例,示範使用 Random Forest 訓練分類模型、以 Pickle 匯出與載入模型二進制檔案,並在 Streamlit 前端收集使用者特徵數據完成即時預測,最後簡述課程作業及項目要求。
展開回顧機器學習與 NumPy 基礎,並介紹如何透過 Web API 與 REST 架構在客戶端與伺服器之間進行資料傳輸。
展開講解 GET、POST、PUT、PATCH、DELETE 等請求動詞的用途,以及 200、300、400、500 等狀態碼的含義。
展開安裝 requests 套件,並調用 JSONPlaceholder 測試 API 獲取待辦清單資料並將其轉為 Pandas DataFrame。
展開示範向 JSONPlaceholder 發送 POST 請求,傳遞 JSON 物件並成功接收 201 狀態碼新增記錄。
展開示範針對特定 ID 的記錄發送 PUT 請求進行修改,以及透過 DELETE 請求刪除記錄的流程。
展開示範搜尋並連接金管局開放 API,獲取每日金融市場數據並解析成 DataFrame。
展開使用經緯度等參數調用政府開放數據 API,搜尋特定座標附近的學校並處理嵌套結果。
展開介紹網頁爬蟲工具 Beautiful Soup 的用途,並引出機器學習應用前端部署框架 Streamlit。
展開說明如何在環境中安裝 Streamlit,並在 VS Code 中創建獨立的 Python 檔案進行執行。
展開介紹 title、header、subheader、text_input、button 等 UI 元件,以及 line_chart 和 bar_chart 等圖表功能。
展開加載 Iris 數據集,拆分訓練集與測試集,訓練隨機森林分類器並計算模型準確率。
展開介紹如何使用 Pickle 套件以二進制寫入模式(wb)將訓練好的模型保存為 .pkl 檔案。
展開在獨立的 Python 檔案中建立輸入表單,收集萼片與花瓣長寬共四項特徵數據。
展開使用 pickle.load 載入模型,將用戶輸入轉換為 NumPy 二維陣列並進行預測,輸出花卉品種。
展開說明機器學習相關作業與項目的要求、評分標準及參考範例,並提醒提交期限。
展開每課 Quiz 及格分數為 60 分。在學習系統完成測驗並達標後,可向 UNiSOFT 申請由學校發出的課程證書。完整測驗、成績與重做次數於系統內進行(demo / demo)。
本課為機器學習補充課程,涵蓋三大核心主題。首先深入探討非監督式學習的 K-means 分群演算法,透過手動計算歐氏距離及使用 Scikit-Learn 與 NumPy 進行多群集擬合與散佈圖視覺化。接著介紹利用 Streamlit 快速將機器學習模型包裝為互動式網頁應用,並示範透過 Git 與 GitHub 將程式碼推送並部署至 Streamlit 社群雲端,同時結合 Pickle 將訓練好的鳶尾花隨機森林模型導入網頁以進行動態預測。最後進入大語言模型領域,剖析 Transformer 架構、Self-Attention 機制及編碼器與解碼器差異,並實作於本機端使用 Ollama 下載 Gemma、LLaVA 等模型進行問答與影像辨識,再藉由 LangChain 框架進行文本分塊、向量嵌入與 Chroma 向量資料庫檢索,實現本地私有文件的檢索增強生成問答系統。
展開介紹本堂補充課程的重點目標,包括非監督式學習的 K-means 分群、Streamlit 網頁部署以及本地端大語言模型(LLM)的應用。
展開透過 Excel 人手示範座標點與隨機中心點的距離計算,說明歐氏距離公式的運算邏輯與群組分配流程。
展開在 Jupyter Notebook 中利用 sklearn.cluster 模組匯入 KMeans,對資料集進行擬合並輸出分群中心點與標籤。
展開介紹使用 numpy.random.randint 快速生成多維隨機點,並透過 Matplotlib 散佈圖及色彩映射展示分群結果與中心點。
展開示範如何安裝 Streamlit、使用 VS Code 編寫簡單的 Python 網頁腳本,並透過命令提示字元啟動本地 Web 伺服器。
展開說明將 Streamlit 應用發布至 Streamlit Community Cloud 的流程,並介紹版本控制工具 Git 與遠端 GitHub 帳號的設定。
展開示範在 GitHub 建立 Repository,並在本地終端機執行 git init、git add、git commit 及 git push 將程式碼上傳。
展開將 GitHub 上的專案連結至 Streamlit Cloud,成功部署具有獨立專屬網址的線上互動式網頁應用。
展開使用 RandomForestClassifier 訓練鳶尾花分類模型,並利用 pickle 模組將模型序列化儲存為二進位檔案以供重用。
展開解說自然語言處理革命性的 Transformer 模型、Self-Attention 機制,以及純編碼器、純解碼器與編解碼器模型的差異。
展開介紹 Ollama 平台的安裝與配置,讓使用者無需連網即可在本地電腦下載與運行各種開放原始碼大語言模型。
展開透過終端機向本地 Gemma 2B 模型提問,並利用多模態模型 LLaVA 對傳入的圖像進行場景與物件識別分析。
展開介紹 LangChain 的兩階段工作流,示範載入文字檔與 PDF 文件,並使用 Text Splitter 將文章切割為多個文字區塊(Chunks)。
展開將文本轉換為向量嵌入(Vector Embedding)並存入 Chroma 資料庫,最後執行相似度檢索並結合大語言模型生成精準回答。
展開每課 Quiz 及格分數為 60 分。在學習系統完成測驗並達標後,可向 UNiSOFT 申請由學校發出的課程證書。完整測驗、成績與重做次數於系統內進行(demo / demo)。
擁有豐富的商業網站及應用程式系統開發經驗,超過 25 年教學經驗。教學風格清晰,能把複雜技術簡化為易於理解的概念。現為 NCC Education 和 University of Greenwich 首席講師,專長辦公室自動化、數據科學、數據分析及商業系統開發。
持有 IT 學士、MBA、IT 碩士及電信碩士學位;曾為知名企業、政府部門及本地大學提供工作坊與課程。
進入課程播放器後,左側是課堂大綱與進度;影片下方可跳到 AI 章節、打開本課摘要,以及進行課後 Quiz。你可標示已看、上一課/下一課切換,不必跟任何人的上課時間。
付款後從「我的課程」進入播放器,無需等待開課日。
每課約 2.5 小時實體課堂原片,可暫停、重播、調速度。
時間章節對應真實錄影時間點,摘要幫你先抓該段重點。
每課測驗可重做。及格 60 分後,可向學校申請課程證書。

UNiSOFT 曾為政府部門、大學、銀行及企業提供 IT 與自動化培訓。以下為部分客戶。

Copyright © 2026 UNiSOFT Education Centre. All Rights Reserved